每0.7秒决定说还是听,蚂蚁开源Duo v1
每0.7秒决定说还是听,蚂蚁开源Duo v1

Ai热点前沿11-18 02:00
2026-11-18 10:00
导语:每0.7秒自主决定说或听,4步蒸馏实现实时生成。Duo v1是什么 Duo v1 是蚂蚁技术研究院与西湖心辰联合开源的全
Duo v1是什么
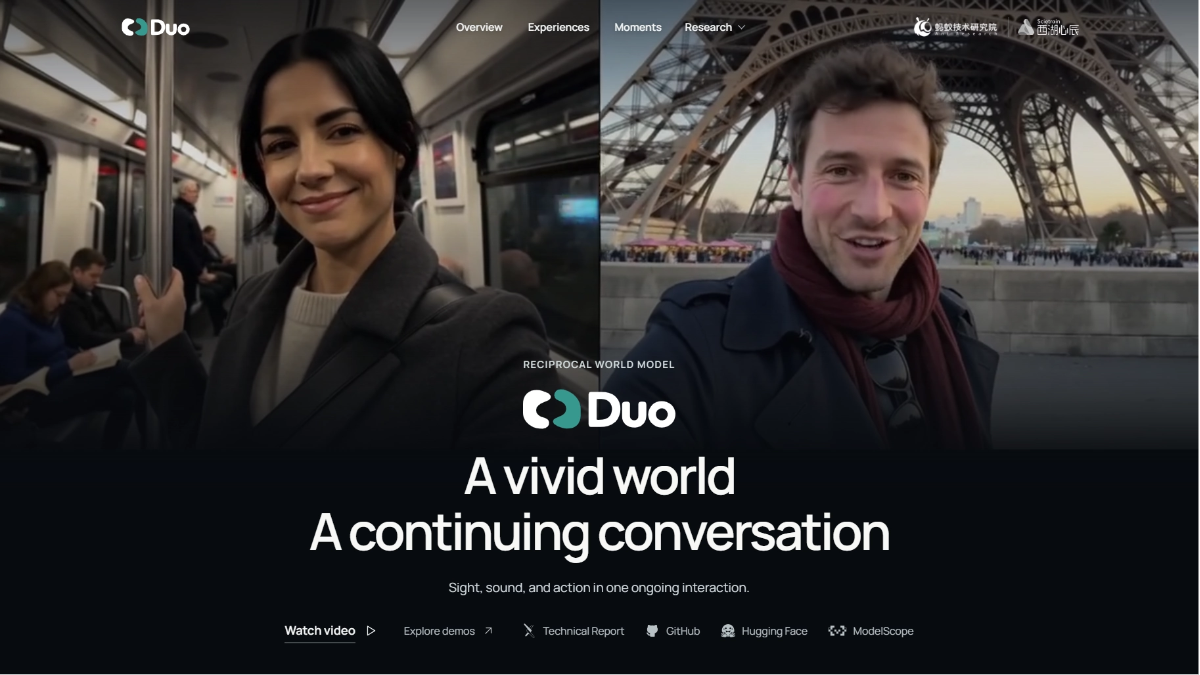
Duo v1 是蚂蚁技术研究院与西湖心辰联合开源的全双工音视频交互模型,也是首个 Reciprocal World Model(双向世界模型)实现。Duo v1由 Intent 与 Realization 两个耦合模块构成,Intent 作为虚拟主体的”大脑”,每约0.7秒自主决策说话或倾听并生成内容;Realization 基于其隐状态因果生成一致的音视频。三阶段训练加 Dual Rollout 解决推理分布偏移,最终蒸馏为4步实时生成。
Duo v1的主要功能
- 全双工实时交互:边说边听,模型在音视频输入的同时自主决定何时开口、何时倾听。
- 自主参与决策:不是被动执行指令,而是基于对话上下文原生判断
<speak>或<wait>。 - 联合音视频生成:音频与视频统一生成,保证口型、表情与语音内容一致。
- 打断响应:能处理用户的自然打断并调整回应,而非按脚本顺序播放。
- 身份与情感一致性:在交互过程中保持角色视觉外观和视听情感的稳定。
- 多角色多场景:支持动物、虚拟人物等多种角色,覆盖对话、指导、协作、陪伴四类场景。
Duo v1的技术原理
- 双向世界模型(RWM):传统世界模型只模拟物理场景,用户在外部控制;RWM 把智能主体内化为世界的一部分,虚拟主体与世界共享同一交互时空,具备感知、决策和表达能力,而非被操控的 NPC。
- Intent 模块(认知主体):用约 0.7 秒为一个时间块,基于用户输入和交互历史连续推理,输出
<speak>/<wait>决策和语言内容;输出的是隐状态,直接作为 Realization 的条件信号。 - Realization 模块(视听表达):基于 Intent 隐状态、用户输入和自身生成历史,联合生成音视频;通过模块特定的因果注意力掩码,确保任何时刻都不能访问未来输入,训练与推理保持一致。
- 三阶段训练:第一阶段训练 Intent 做参与决策和文本预测,用动作感知重平衡解决”过度等待”偏差;第二阶段冻结 Intent,训练 Realization 做因果联合视听生成;第三阶段用分布匹配蒸馏压缩为 4 步生成器以满足实时性。
- Dual Rollout:解决训练用录制媒体、推理用自己生成历史的分布偏移,冻结 Intent 自回归生成文本,Realization 在自身合成的视听历史上训练。
- 数据构建:合成数据由 LLM 按控制卡片生成剧本再逐块生成视频,并用固定 opening video 作参考抑制误差累积;录制数据经 ASR、VAD、说话人分离和时间轴对齐后统一为因果交互格式,再经四类自动质检过滤。
微信关注回复“开源”,加入AI开源项目交流群
如何使用Duo v1
- 环境准备:准备 Linux + Python 3.10+ + FFmpeg + 2 张 CUDA GPU,克隆仓库后分别创建并安装
.venv-model(先装匹配 CUDA 的 PyTorch,再pip install -e '.[realization]')和.venv-speech(pip install -e '.[speech]')两个虚拟环境。 - 下载权重:执行
hf download inclusionAI/Duo-1.2-causal-base --local-dir weights下载完整模型包(含 ASR 与对齐模型),或先下Duo-1.0-causal-base再叠加Duo-1.0-distill获得 4 步实时生成。 - 复制配置:
cp configs/inference.example.json configs/inference.json。 - 填写配置:在
inference.json中填好三个 Python 可执行路径(realization / intent / speech 分属两个虚拟环境)及各模型权重目录。 - 启动服务:运行
.venv-model/bin/python run_demo.py --config configs/inference.json --port 4173。 - 开始使用:浏览器打开
http://127.0.0.1:4173/video/index.html,录制或上传 MP4/WebM 视频可生成并播放 Duo 的音视频回应。
Duo v1的核心优势
- 双向世界模型范式:首个将智能主体内化为世界一部分的 Reciprocal World Model,虚拟主体不再是受外部操控的 NPC。
- 原生全双工能力:Intent 模块每约 0.7 秒自主决策
<speak>/<wait>,天然支持边说边听、打断响应。 - 严格因果一致性:模块特定的注意力掩码强制统一时间线上的因果依赖,任何模块都无法访问未来输入,保证训练和推理行为一致。
- 端到端联合生成:音频与视频由 Realization 模块联合生成,从机制上保障口型、表情、语音内容的一致性。
Duo v1的项目地址
- 项目官网:https://duo-v1.github.io/
- GitHub仓库:https://github.com/inclusionAI/Duo
- HuggingFace模型库:https://huggingface.co/collections/inclusionAI/duo-v1
- arXiv技术论文:https://arxiv.org/pdf/2611.15131
Duo v1的同类竞品对比
| 对比维度 | Duo v1 | Gemini Live |
| 核心范式 | Reciprocal World Model(双向世界模型) | 实时多模态语音/视频交互 API |
| 输出形态 | 音视频联合输出(生成虚拟主体的画面+声音) | 仅语音输出(可”看懂”视频但不生成形象) |
| 交互决策 | Intent 模块每 0.7 秒自主决策说/听,决策内生于模型 | 全双工原生源,但参与节奏由服务端策略调控 |
| 世界模拟能力 | 场景作为交互时空的一部分被联合建模 | 无(专注对话理解,不模拟物理世界) |
| 开放程度 | 完全开源:报告 + 代码 + 权重(Apache 2.0),支持自托管 | 闭源 API(~$0.01/分钟起,按 token 计费) |
| 延迟 | 4 步蒸馏生成 + 约 0.7 秒 chunk 节律 | 端到端约 300–500 ms |
| 部署门槛 | 高:需 2 张 CUDA GPU 自托管 | 低:调用 API 即可 |
| 语言支持 | 以中英为主(训练数据双语混合) | 90+ 语言,业界最广 |
Duo v1的应用场景
- AI 陪伴与情感陪伴:生成猫咪、动漫女孩等虚拟伙伴,进行有表情、有情绪起伏的日常闲聊与陪伴。
- 在线教育与辅导:虚拟老师实时讲解并观察学生反应,根据学生的提问和困惑自主调整教学节奏。
- 智能客服与导购:数字人客服边看用户演示边实时解答,用户可随时打断追问,接近真人柜面交流体验。
- 远程协作与共同规划:虚拟同事参与方案讨论、共同修改计划(如”一起改生日计划””围绕材料做设计”类协作对话)。
- 无障碍交互:为视障/听障用户提供兼具语音与可视化形象的实时双向交流界面,用情感一致的视听输出降低沟通门槛。
来源:AI工具集
#AI工具
免责声明:含第三方意见,不构成财务建议
分享至


推荐阅读
Step Code – 阶跃星辰开源的终端编程智能体
09-24
Hy4 preview 轻量版 – 腾讯混元开源的Hy4量化压缩模型
09-02
Claude Fable 5.1 – Anthropic 推出的最新旗舰大模型
09-02
开源版Retool来了,60+组件拖拽搭后台
08-19
Claude Opus 5来了:半价逼近Fable 5
07-25
腾讯开源260个真实任务,考AI打工能力
07-25
美团开源AI考场:813个Minecraft任务
07-25

Step Code – 阶跃星辰开源的终端编程智能体

Hy4 preview 轻量版 – 腾讯混元开源的Hy4量化压缩模型

Claude Fable 5.1 – Anthropic 推出的最新旗舰大模型

开源版Retool来了,60+组件拖拽搭后台

Claude Opus 5来了:半价逼近Fable 5

腾讯开源260个真实任务,考AI打工能力

美团开源AI考场:813个Minecraft任务