开源Lev:多算几圈,准确率从63.2%升至76.2%
开源Lev:多算几圈,准确率从63.2%升至76.2%

Ai热点前沿11-17 02:40
2026-11-17 10:40
导语:同一权重按难度循环加深,四圈准确率升至76.2%。Lev是什么 Lev 是 Lehigh 大学等推出的开源决策模型,基于
Lev是什么
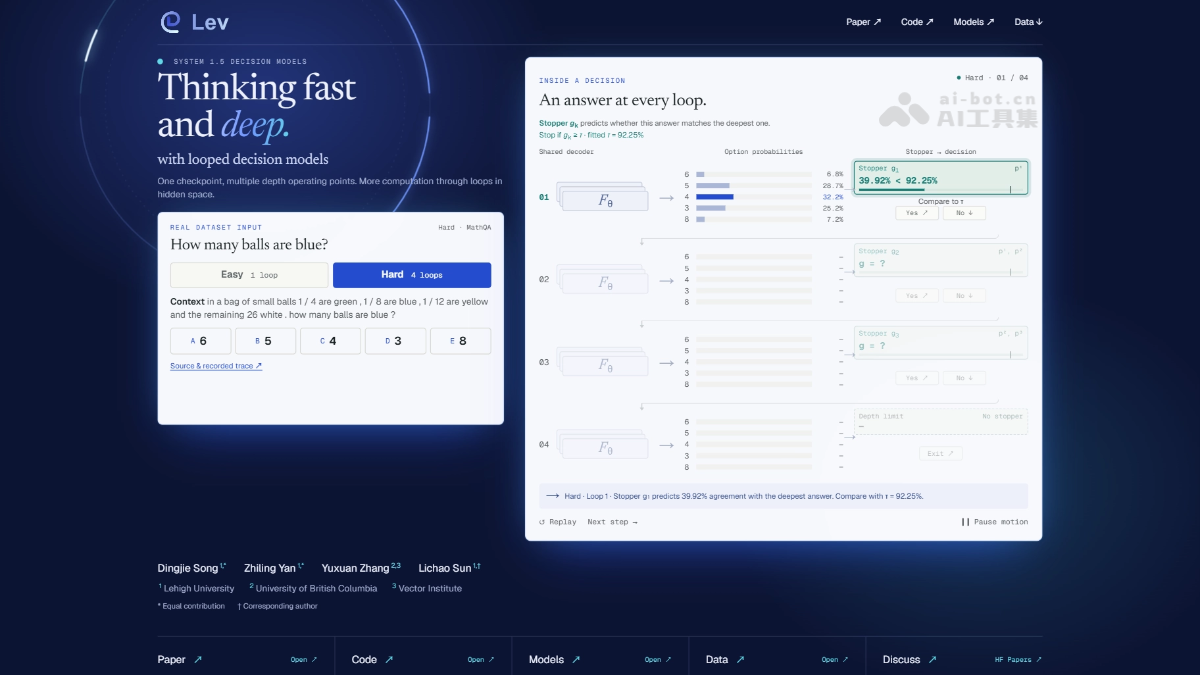
Lev 是 Lehigh 大学等推出的开源决策模型,基于原生循环底座(Ouro/Nanbeige),同一组权重重复计算多圈,每圈都可读出选项概率,由轻量停止器按题目决定算几圈,简单题一圈快答,难题多算几圈。Lev 在 JevBench 上同一 checkpoint 从一圈的 63.2% 提升到四圈的 76.2%,仅用约八成的计算,准确率损失不足 1 个点。
Lev的主要功能
- 一次前向给出决策:读入状态、问题和候选项,直接输出每个选项的概率,不生成推理文本。
- 循环加深思考:同一组解码层重复运行多圈,每圈都读一次选项概率,同一份权重支持任意深度作答。
- 逐题按需停算:内置轻量停止器预测,当前答案是否与最深一圈一致,按题目难度自动决定算几圈。
- 延迟与准确率可切换:一份权重可在毫秒级快答和深度思考之间取舍,无需为每种预算部署不同模型。
- 无标签自校准:停止器可用自有业务流量校准,不需要人工标注数据,每折约 500 题即可。
Lev的技术原理
- 决策模型接口:状态与多问题共享编码, Lev 沿用 Kev 式的输入结构:一次请求包含一段共享状态和若干问题,每个问题附带自己的候选项;所有内容被打包成一条序列,通过块因果掩码让每个问题只能看到状态和它自己的问题。这样状态只编码一次,却能让每个问题像单独提问一样作答。
- 原生循环底座:让”多想”发生在隐藏状态里,与在 dense 模型上事后加装循环不同,Lev 直接选用预训练时就带逐圈监督的原生循环语言模型 Ouro 和 Nanbeige4.2 作为底座,同一组解码层重复运行 R 次,后续每一圈都在上一轮隐藏状态上继续计算。
- 逐圈读出 + 联合训练:一份权重覆盖所有深度,每一圈结束后,共享的 pointer head 读取各选项结束符和 <decide>
- 停止器:预测”与最深答案一致”而非”答对”, 传统置信度早退在决策模型上迁移失败,因此 Lev 的停止器改为一个每深度一个的逻辑回归,用当前圈与上一圈读出的特征预测当前答案是否已与最深一圈一致。由于”最深答案”就是模型自己的输出,拟合停止器和选取阈值都不需要人工标签,可直接用业务无标签流量校准,阈值取保证至少 98% 与最深答案一致的最小值。
微信关注回复“开源”,加入AI开源项目交流群
如何使用Lev
- 获取代码与模型:从 GitHub 克隆仓库,从 Hugging Face 下载对应底座 和 Lev checkpoint 及 LoRA 权重。
- 准备输入:把状态、问题和各自的候选项打包成一条序列,模型用块因果掩码保证每个问题只能看到状态和自己。
- 选择循环深度:决定最多算几圈,加载共享的 pointer head 和 LoRA 适配器。
- 逐圈推理并读出:同一组解码层循环运行,每圈后读取各选项的概率,可从上一圈隐藏状态直接续算,无需重读输入。
- 应用停止器:用训练好的逻辑回归停止器判断当前答案是否已与最深一圈一致,一致就提前停,每道题可各自退出。
- 部署前校准:用自有业务的无标签请求为各深度拟合温度和停止阈值。
Lev的核心优势
- 一份权重多个深度:同一 checkpoint 通过循环圈数在快答和深思之间切换,无需为不同预算各部署一个模型。
- 难题收益显著:在 JevBench 上同一权重从一圈的 63.2% 提升到四圈的 76.2%,提升主要来自标准题和难题。
- 续算不重读:从上圈隐藏状态继续,避免级联方案中重新读入输入的延迟开销。
- 计算花在刀刃上:停止器自动把更多圈分配给难题,仅用约 76%–85% 的计算,准确率损失不足 1 个点。
- 校准无需标签:停止器以「与最深答案一致」为目标,可直接用自有业务流量校准,每折约 500 题即可。
- 低延迟区间占优:在 39–46ms 区间比同级联方案高 7.0–8.8 个点,比最好的 dense 方案高 5.4–7.5 个点。
Lev的项目地址
- 项目官网:https://openlair.github.io/lev/
- GitHub仓库:https://github.com/OpenLAIR/lev
- HuggingFace模型库:https://huggingface.co/collections/songdj/lev
- arXiv技术论文:https://arxiv.org/pdf/2610.20951
Lev的同类竞品对比
| 对比维度 | Lev(以 Lev-2.6B 为例) | Jev |
|---|---|---|
| 提供方性质 | Lehigh 大学等学术团队,完全开源(代码/权重/数据) | TypeSafe AI 商业化产品,闭源、仅托管 API |
| 架构 | 原生循环底座(Ouro),同一组层多圈复用 | dense,一次前向单次读出,无循环 |
| 参数规模 | 2.6B(另有 1.4B、3B) | 未公开 |
| JevBench 公开题准确率 | 76.2%(四圈);一圈仅 63.2% | 约 86.6%(200/231,第三方实测) |
| 延迟 | 本地 39–150 ms(按深度可变) | 托管 API p50 约 616 ms(含网络传输) |
| 计算深度调节 | 支持: 一份权重多档工作点,难题自动多算 | 不支持: 固定单次前向 |
| 校准 | 各深度需单独温度缩放+停止器校准(无标签即可) | 开箱即用,校准质量好(ECE 0.053) |
| 成本 | 权重免费,自托管成本取决于自有 GPU | 约 \$32/百万次决策(带示例),按输入 token 计费 |
| 数据合规/私有化 | 支持: 可完全离线自部署 | 不支持: 数据须出域到托管 API |
| 成熟度 | 学术原型,底座仅 1.4B–3B | 生产级商业服务,持续迭代 |
Lev的应用场景
- 智能客服意图路由:简单咨询一圈秒回,复杂意图自动多算几圈,一份权重兼顾响应速度与路由准确率。
- 内容审核分级处置:明显违规快速放行/拦截,灰色内容加深判断,整体节省 15%–24% 算力并减少漏判。
- Agent 工具调用选择:机械步骤一圈快答保持执行流畅,关键决策点多算几圈避免选错工具浪费后续步骤。
- 电商推荐实时重排:常规流量浅层排序保速度,大促首屏等高价值位置自动加深计算提升排序准确性。
- 金融合规文档分类:可完全离线自托管满足数据合规,用自有无标签流量校准停止器,难题样本自动加深降低误判。
来源:AI工具集
#AI工具
免责声明:含第三方意见,不构成财务建议
分享至


推荐阅读
Step Code – 阶跃星辰开源的终端编程智能体
09-24
Hy4 preview 轻量版 – 腾讯混元开源的Hy4量化压缩模型
09-02
Claude Fable 5.1 – Anthropic 推出的最新旗舰大模型
09-02
开源版Retool来了,60+组件拖拽搭后台
08-19
Claude Opus 5来了:半价逼近Fable 5
07-25
腾讯开源260个真实任务,考AI打工能力
07-25
美团开源AI考场:813个Minecraft任务
07-25

Step Code – 阶跃星辰开源的终端编程智能体

Hy4 preview 轻量版 – 腾讯混元开源的Hy4量化压缩模型

Claude Fable 5.1 – Anthropic 推出的最新旗舰大模型

开源版Retool来了,60+组件拖拽搭后台

Claude Opus 5来了:半价逼近Fable 5

腾讯开源260个真实任务,考AI打工能力

美团开源AI考场:813个Minecraft任务